Inhalt
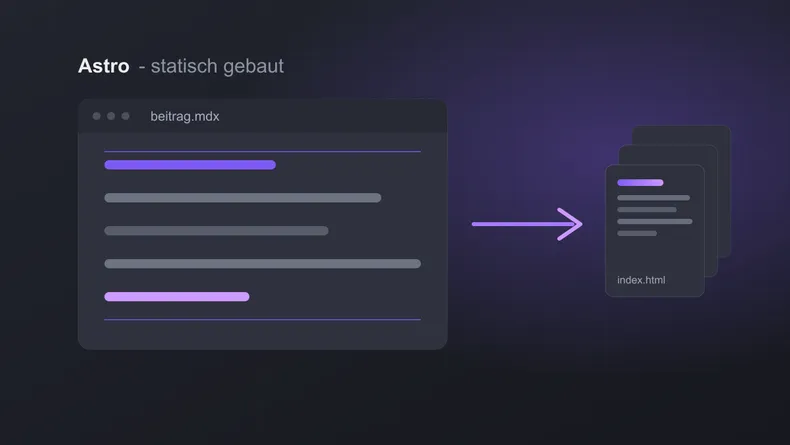
Der erste Beitrag handelt vom Blog selbst. Kurzfassung: Es gibt
keine Datenbank, kein CMS und keinen Server, der zur Laufzeit etwas rendert. Ein Beitrag ist einfach eine
Datei im Repository, und npm run build macht das fertige, statische HTML daraus.
Warum Astro
Das Layout stammt aus einem Next.js-Theme. Für einen Blog, der aus Text und ein paar Bildern besteht, ist React zur Laufzeit aber viel Gepäck für wenig Nutzen. Astro rendert alles beim Bauen und liefert von sich aus kein JavaScript aus. Nur dort, wo ein Skript wirklich gebraucht wird (sticky Header, mobiles Menü, back-to-top), kommt ein kleines Inline-Skript dazu. Auf der Startseite sind das zusammen rund 2,4 KB. Also überschaubar.
Ein Beitrag ist ein Ordner
Ein Beitrag ist ein eigenes Verzeichnis, und darin liegt alles, was dazu gehört: der Text, das Titelbild
Codeausschnitte, Diagramme, usw.. Der Name des Ordners wird dabei zur URL: wie-dieser-blog-gebaut-ist/ ergibt
/beitraege/wie-dieser-blog-gebaut-ist/.
index.mdx            Frontmatter und Text
astro-setup.png      Titelbild
build-pipeline.mmd   das Diagramm weiter unten
content-config.ts    der Codeausschnitt direkt hier drunter
Oben in der index.mdx steht das Frontmatter, darunter Markdown. Pflicht sind vier Felder, der
Rest ist freiwillig. Und weil es MDX ist, kann man bei Bedarf eigene Komponenten wie die Hinweisbox
weiter oben ergänzen.
---
title: "Wie dieser Blog gebaut ist"
description: "Astro und MDX: ein Blog ohne Server, CMS und Datenbank."
pubDate: 2026-09-14
category: "Softwareentwicklung"
tags: ["Astro", "MDX", "Azure Static Web Apps"]
cover: "./astro-setup.png"
coverAlt: "Schematischer Aufbau einer statischen Website"
updatedDate: 2026-10-02
reviewedDate: 2027-03-01
series: {}
author: "Philipp"
draft: false
---

import { Callout } from "@components/content";

Normaler Markdown-Text.

<Callout type="tip">Und eine Hinweisbox.</Callout>
Das Frontmatter ist ein Schema. Astro nennt das Content
Collections1 und prüft die Felder beim Build mit Zod. Der Ausschnitt steht nicht im Text,
sondern in content-config.ts daneben - <Include /> holt ihn beim Bauen herein:
const blog = defineCollection({
  loader: glob({ base: "./src/content/blog", pattern: "**/index.{md,mdx}" }),
  schema: ({ image }) =>
    z.object({
      title: z.string().max(120),
      description: z.string().max(320),
      pubDate: z.coerce.date(),
      updatedDate: z.coerce.date().optional(),
      reviewedDate: z.coerce.date().optional(),
      category: z.string(),
      series: z
        .object({ name: z.string().max(80), part: z.number().int().positive() })
        .optional(),
      tags: z.array(z.string()).default([]),
      cover: image().optional(),
      coverAlt: z.string().default(""),
      author: z.string().default(AUTHOR.name),
      draft: z.boolean().default(false),
    }),
});
Aus dem Frontmatter entsteht mehr als der Beitrag selbst. Jede Kategorie und jedes Schlagwort bekommt automatisch eine eigene Übersichtsseite, ohne dass irgendwo etwas registriert werden muss. Das ist schon sehr cool.
Was beim Bauen passiert
npm run build erzeugt den Ordner dist/. Und der ist alles was dann später auf dem Server liegt.
| Was | Wie |
|---|---|
| Seiten | Eine index.html pro URL fertig gerendert |
| Bilder | Aus dem Ordner des Beitrags |
| Schrift | Wird selbst gehostet |
| Icons | Font-Awesome-CSS auf die genutzten Icons reduziert: 532 KB → 19 KB |
| Suchindex | Pagefind läuft nach dem Build über dist/ und legt den Index daneben |
| RSS, Sitemap | Aus denselben Daten wie die Seiten |
Zur Laufzeit passiert dann nichts mehr. Keine Cookies, keine Magic, kein Analytics. Die Datenschutzerklärung ist daher entsprechend kurz.
Suche ohne Server
Die Volltextsuche läuft komplett im Browser. Pagefind2 zerlegt beim Build alle Beiträge in einen Index aus kleinen Fragmenten, von denen der Browser nur die lädt, die zum Suchbegriff passen. Indiziert wird auch nur entsprechend im Beitragslayout Markiertes.
Diagramme
Bilder sagen mehr als Worte. Wenn ein Diagramm notwendig ist, muss im Beitrag einfach nur ein Codeblock mit der Sprache
mermaid3 hinterlegt werden. Daraus wird beim Bauen dann ein fertiges SVG.
flowchart LR
  A[MDX im Repo] --> B[astro build]
  B --> C[dist/]
C --> D[Azure Static Web App]Gerendert wird das von rehype-mermaid mit einem echten Browser (playwright). Das kostet rund 35 Sekunden Build-Zeit.
Im Client läuft dafür nichts! Kein Diagramm-Framework, kein zusätzliches JavaScript, nur das Bild als fertiges SVG.
Veröffentlichen
Ein Push auf den main-Branch. GitHub Actions installiert notwendige Abhängigkeiten, prüft Frontmatter,
baut die Seite und deployed das Artefakt als Azure Static Web App.
Weil die Seite rein statisch ist, entscheidet sich auch beim Bauen, was Teil des finale Artefakts ist. Ein Beitrag mit pubDate
in der Zukunft wird nicht versteckt, sondern gar nicht erst gebaut und ist daher auch nirgens verfügbar.
export async function getPublishedPosts() {
  const now = Date.now();
  const posts = await getCollection(
    "blog",
    ({ data }) => import.meta.env.DEV || (!data.draft && data.pubDate.valueOf() <= now),
  );
  return posts.sort((a, b) => b.data.pubDate.valueOf() - a.data.pubDate.valueOf());
}
Fazit
Ein Blog braucht keinen Server-Part. Ein Ordner mit Markdown-Dateien, eine Build-Pipeline und ein statisches Hosting reichen. Das Ergebnis ist schnell, günstig und wartungsarm. Will man einen Beitrag schreiben braucht man also nur einen Editor.